기본 개념
-
CPU
- 적은 수의 강력한 코어로 복잡한 명령과 분기 처리를 빠르게 수행하는 데 적합
-
GPU
- 많은 연산을 병렬로 실행하여 대량의 수치 계산을 처리하는 데 적합
-
GPU 커널(Kernel)
- GPU 커널은 GPU에서 실행되는 병렬 계산 함수
- 여러 연산을 하나로 합치는 기술을 Kernel Fusion(커널 융합)
PyTorch의
torch.compile역시 이러한 융합을 자동 수행할 수 있음. 직접 구현한 커널이 항상 더 빠른 실행 속도를 보장하지 않음.
GPU 내부 구조
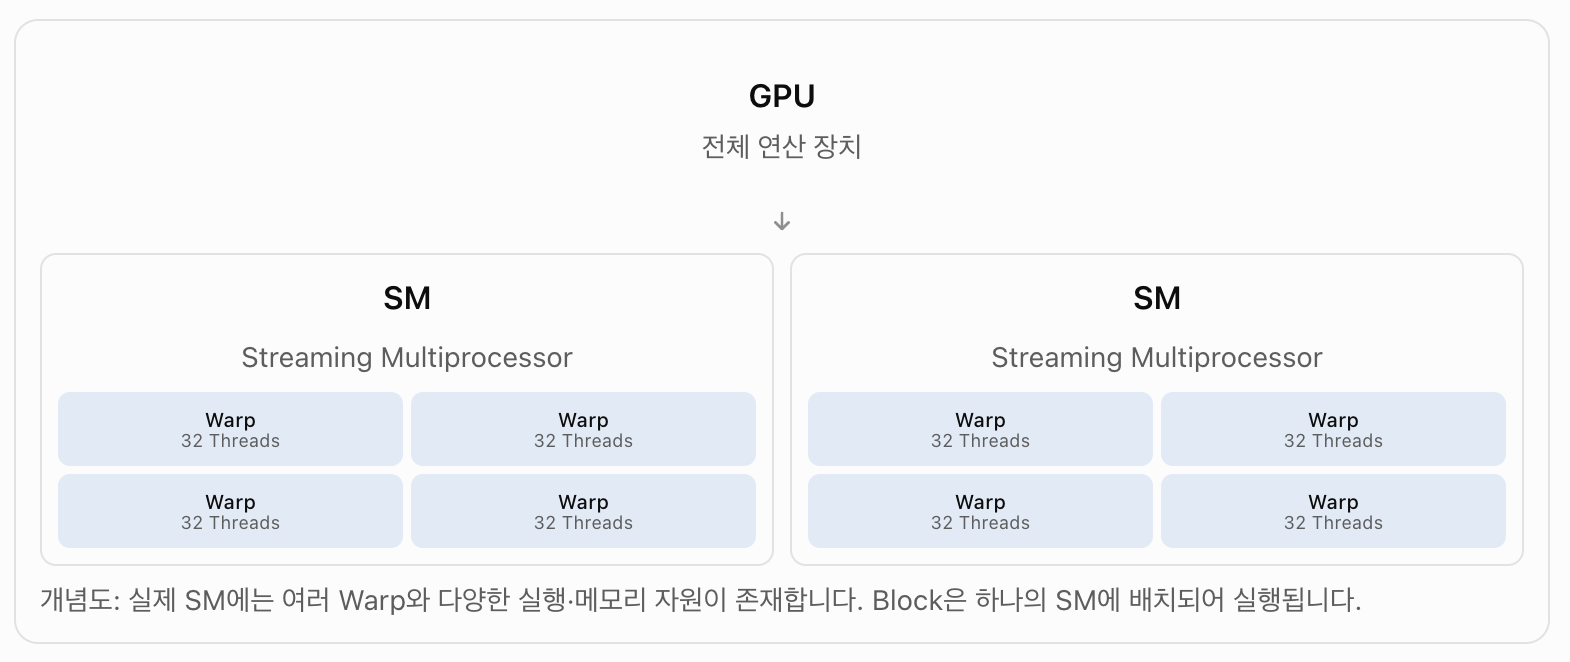
| 개념 | 의미 |
|---|---|
| SM | Block을 배치받아 실행하는 GPU 내부 프로세서 |
| Block | 여러 Thread를 묶은 실행·협업 단위 |
| Warp | 일반적으로 32개 Thread를 묶어 실행하는 단위 |
| Thread | 개별 계산을 수행하는 실행 단위 |
| CUDA에서는 Thread와 Block을 직접 구성하는 경우가 많음. |
- Triton
- 보통 하나의 프로그램 인스턴스가 처리할 데이터 타일을 정의
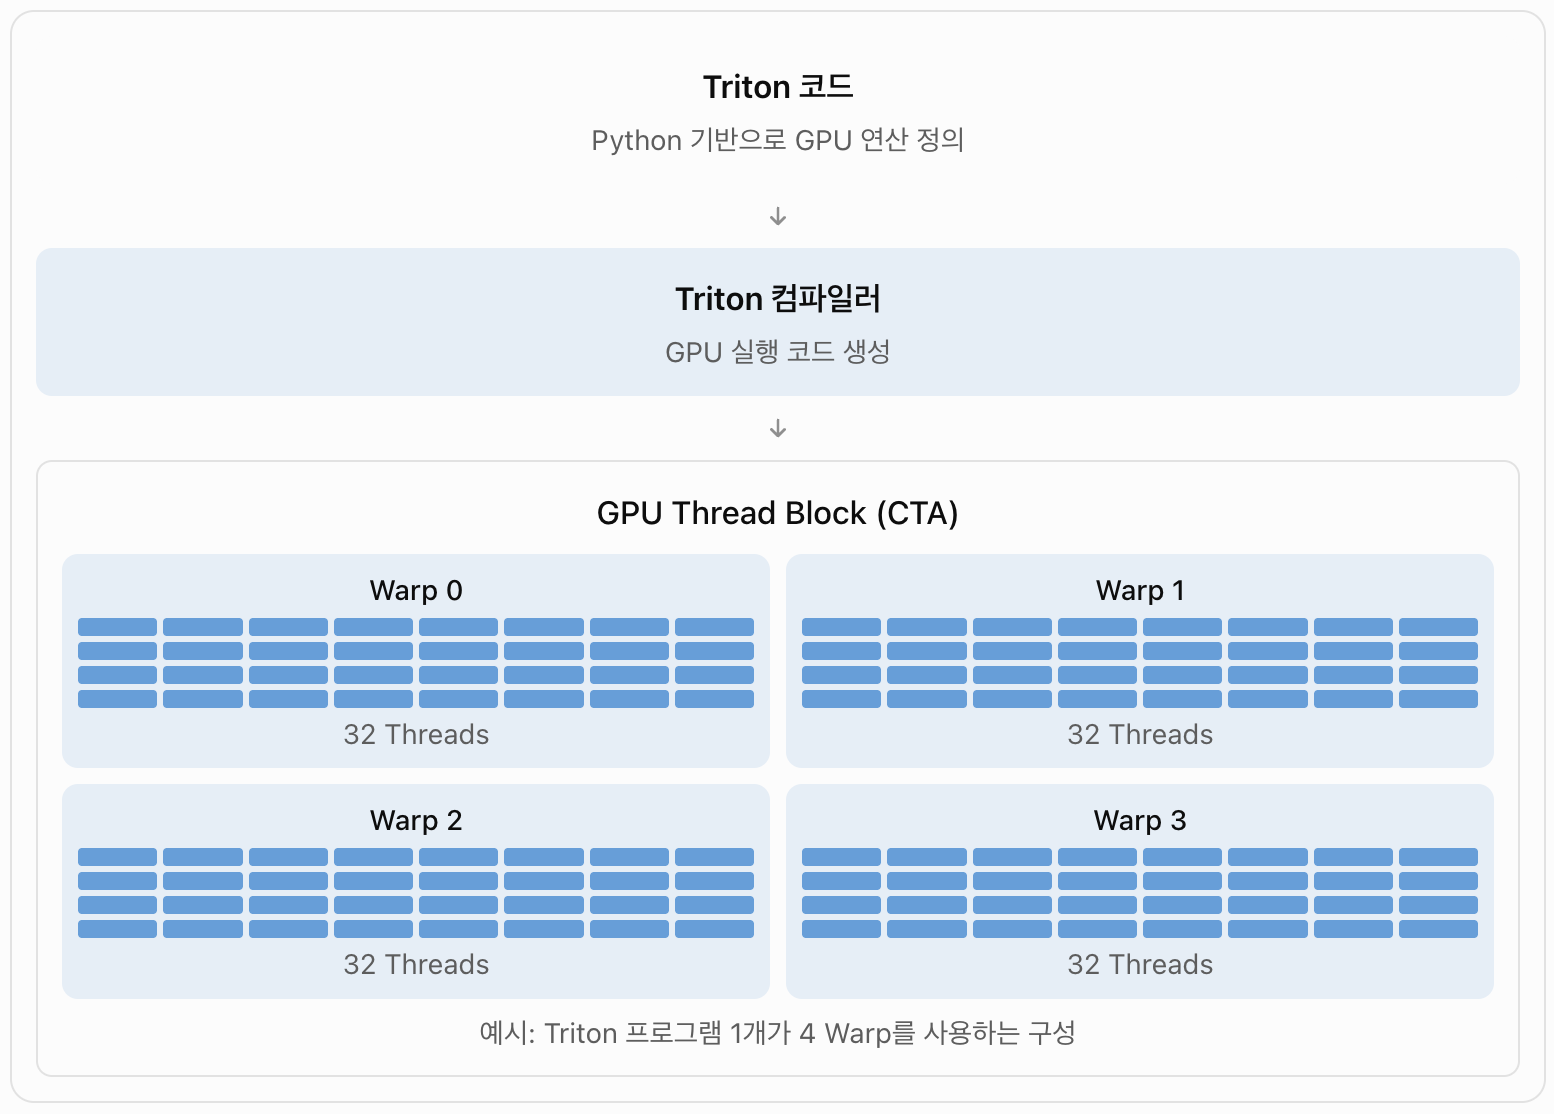
- 보통 하나의 프로그램 인스턴스가 처리할 데이터 타일을 정의
| Warp | Block | Triton |
|---|---|---|
| 하드웨어 실행 단위 | 스레드 그룹 | GPU 프로그래밍 언어·컴파일러 |
| 32개 Thread | 여러 Thread | 여러 GPU 프로그램 인스턴스 |
| 명령 병렬 실행 | 작업 분할·협업 | GPU 커널 구현 |
| NVIDIA에서 32 Thread | 개발자가 설정 | 처리할 타일 크기를 설정 |
| 스레드별 레지스터 등 | Shared Memory 공유 | 메모리 접근을 컴파일러와 코드로 제어 |
| Block 내부에 존재 | 여러 Warp로 구성 | 컴파일 결과가 Block·Warp를 사용 |
GPU 성능 핵심: 메모리
커널 최적화의 대표적인 방법은 느린 메모리 접근을 줄이고, 이미 읽은 데이터를 최대한 재사용하는 것
- Tiling
- e.g. 행렬곱에서는 입력 행렬의 일부를 타일 단위로 가져와 여러 곱셈에 재사용
| 개념 | 설명 | 적용 예시 |
|---|---|---|
| Memory Coalescing | 인접 스레드가 연속적인 주소에 효율적으로 접근 | Vector Add |
| Tiling | 데이터를 작은 블록으로 나누어 재사용 | MatMul |
| Kernel Fusion | 여러 연산을 하나의 커널로 통합 | Softmax, LayerNorm |
| Occupancy | SM에서 실행 가능한 Warp의 활성화 수준 | 블록·레지스터 설정 |
-
Memory-bound:
- 연산보다 데이터 이동이 병목인 상태
-
Compute-bound:
- 데이터 공급보다 계산 처리량이 병목인 상태
-
Roofline Model:
커널 최적화에서 계산을 더 빠르게 해야 하는지, 메모리 접근을 줄여야 하는지 판단하는 기준이 되는 식-
-
- 실현 가능한 연산 성능
-
- 최대 계산 처리량
-
- 메모리 대역폭
-
- 연산 집약도(FLOPs/Byte)
-
-
CUDA vs Triton
| 비교 | CUDA C++ | Triton |
|---|---|---|
| 언어 | C++ 기반 | Python 기반 DSL |
| 병렬화 | Thread·Block을 명시적으로 제어 | 타일·프로그램 단위 기술 |
| 최적화 | 낮은 수준의 제어 가능 | 텐서 연산 표현과 최적화에 편리 |
| 학습 난이도 | 상대적으로 높음 | 상대적으로 낮음 |
| 주요 활용 | 범용 GPU 커널 | 딥러닝 연산 커널 |
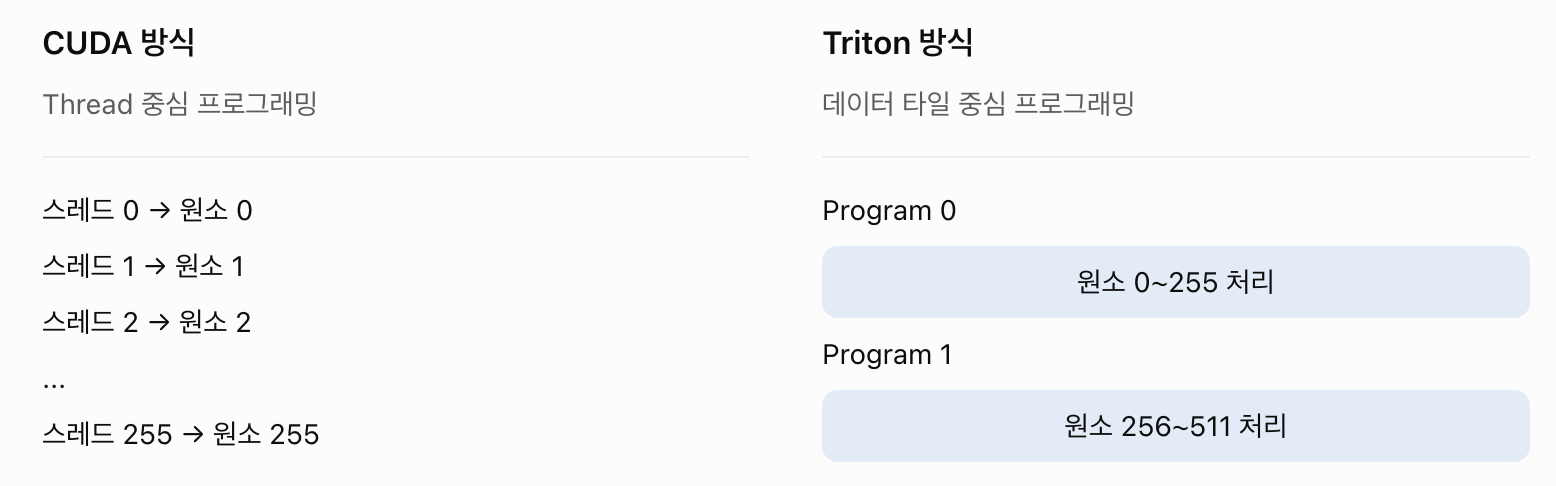 | ||
| Triton 문법이 Python과 비슷하다고 해서 일반 Python 코드처럼 실행되는 것은 아님. | ||
@triton.jit으로 정의한 코드를 GPU 커널로 컴파일 |